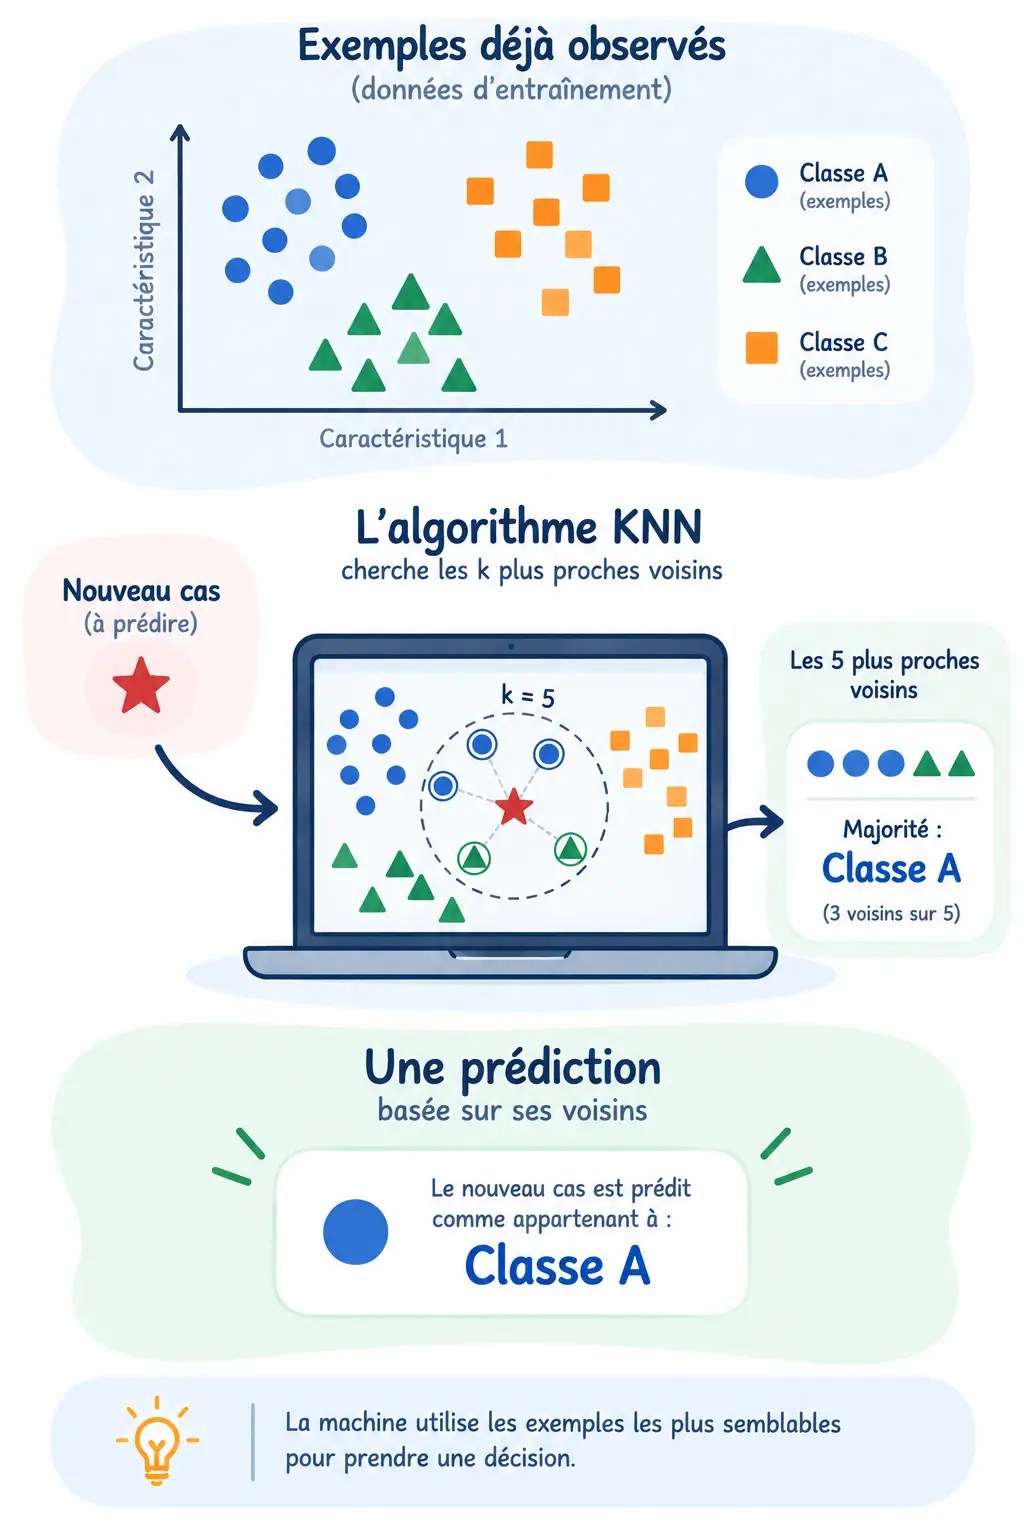
Comment une machine peut-elle effectuer une prédiction à partir d’exemples déjà observés ? L’algorithme des k plus proches voisins, souvent désigné par l’acronyme KNN, répond à cette question avec une idée particulièrement intuitive : rechercher les observations qui ressemblent le plus à un nouveau cas et utiliser ces voisins pour prendre une décision.
Commençons par un cas concret
Imaginons que nous disposions d’informations sur plusieurs personnes. Pour chacune d’elles, nous connaissons seulement deux caractéristiques, l’âge et la taille, ainsi qu’une préférence sportive déjà observée parmi trois possibilités : la course, le basketball et la natation. L’objectif n’est évidemment pas de prétendre que l’âge et la taille déterminent réellement une préférence sportive. Ce jeu de données est volontairement fictif et simplifié afin de rendre visible le fonctionnement mathématique de l’algorithme.
Une nouvelle personne appelée Alex arrive maintenant dans notre jeu de données. Nous connaissons son âge et sa taille, mais sa classe est inconnue : l’objectif est donc de déterminer à laquelle des trois catégories il serait associé par notre modèle. Une stratégie naturelle consiste à regarder les personnes qui lui ressemblent le plus. Si la majorité des profils les plus proches appartient à une même catégorie, cette catégorie peut servir de prédiction pour Alex.
L’algorithme ne cherche pas nécessairement à construire une formule explicite reliant directement les caractéristiques à la classe. Il compare plutôt le nouveau cas aux observations déjà disponibles en calculant une distance entre leurs caractéristiques. Cette distance fournit une mesure numérique de leur proximité : plus elle est faible, plus deux observations sont considérées comme proches ou similaires. KNN sélectionne ensuite les k observations ayant les plus petites distances par rapport au nouveau cas et utilise leurs classes pour établir la prédiction.
Observons maintenant KNN en action
Pour déterminer quelles personnes sont les plus proches d’Alex, KNN doit disposer d’une mesure permettant de comparer les observations entre elles. Nous utilisons ici la distance euclidienne : plus la distance entre Alex et une autre personne est faible, plus cette personne est considérée comme proche d’Alex par l’algorithme.
Avant de calculer cette distance, une précaution est nécessaire. Nos deux caractéristiques ne sont pas exprimées dans les mêmes unités : l’âge est mesuré en années et la taille en centimètres. De plus, leurs valeurs ne varient pas de la même manière dans le jeu de données. Si nous utilisions directement les valeurs originales, une caractéristique pourrait avoir davantage d’influence sur la distance simplement à cause de son échelle numérique. Nous standardisons donc chaque caractéristique.
Dans cette expression, x est la valeur originale, μ la moyenne de la caractéristique dans le jeu de données et s son écart-type. Nous appliquons cette transformation séparément à l’âge et à la taille. Une valeur standardisée égale à 0 correspond ainsi à la moyenne, tandis qu’une valeur égale à 1 indique une valeur située à un écart-type au-dessus de la moyenne. Une fois l’âge et la taille standardisés, la distance euclidienne entre deux personnes A et B est calculée par :
Le graphique reste toutefois présenté dans les unités habituelles afin d’être facile à interpréter : l’âge est affiché en années et la taille en centimètres. Ce que nous voyons sur les axes correspond donc aux valeurs originales, mais les distances utilisées par KNN pour choisir les voisins sont calculées avec les valeurs standardisées.
Faites maintenant varier l’âge et la taille d’Alex à l’aide des curseurs, ou cliquez directement dans le graphique pour le déplacer. À chaque changement, l’algorithme standardise les caractéristiques d’Alex, calcule sa distance avec chacune des personnes, classe ces distances de la plus petite à la plus grande et retient les k premières. Ces k personnes constituent les plus proches voisins d’Alex et participent ensuite au vote qui détermine la prédiction.
Voisins retenus
Des personnes aux données numériques
Pour comprendre ce que fait réellement l’ordinateur, il faut traduire notre exemple en langage mathématique. Chaque observation possède ici deux caractéristiques d’entrée, l’âge et la taille, tandis que la préférence sportive constitue la classe que l’on souhaite prédire. Alex peut donc être représenté par un vecteur contenant ses deux caractéristiques. Avec un âge de 26 ans et une taille de 1,76 m, son profil s’écrit simplement sous la forme suivante.
Chaque autre personne possède une représentation du même type. Comme ces vecteurs ne contiennent que deux valeurs, il est possible de les dessiner directement dans un plan où l’âge constitue l’axe horizontal et la taille l’axe vertical.
La notion de distance
Une fois les observations placées dans cet espace, il faut définir ce que signifie être « proche ». KNN utilise pour cela une mesure de distance, et l’une des plus courantes est la distance euclidienne. Pour deux observations décrites par deux caractéristiques, cette distance correspond simplement à la longueur du segment qui les sépare dans le plan. Elle peut être calculée à l’aide de l’expression suivante.
Plus cette distance est petite, plus les observations sont considérées comme similaires au sens des caractéristiques utilisées. La notion de « voisin » dans KNN n’est donc pas une appréciation subjective : elle est définie mathématiquement par cette distance.
Pourquoi la valeur de k est-elle importante ?
Une fois les distances calculées, toutes les observations sont classées de la plus proche à la plus éloignée. Le paramètre k indique combien de ces observations doivent participer à la décision finale. Une petite valeur de \(k produit une décision très locale, tandis qu’une valeur plus élevée fait intervenir un voisinage plus large. Ce choix influence donc directement le comportement du modèle.
Trois classes signifient un véritable vote multiclasse
Dans notre exemple, les voisins peuvent appartenir à trois classes différentes : course, basketball ou natation. Une fois les k voisins sélectionnés, l’algorithme compte donc combien d’entre eux appartiennent à chacune des trois catégories. La classe obtenant le plus grand nombre de voix devient la prédiction. Lorsqu’une égalité se produit, cette démonstration utilise le voisin le plus proche parmi les classes concernées pour départager le résultat.
Un détail essentiel : les variables ne sont pas toujours sur la même échelle
Dans notre exemple, l’âge prend des valeurs de l’ordre de 20 à 40, tandis que la taille exprimée en mètres varie seulement autour de 1,50 à 2,00. Utiliser directement ces nombres dans une distance euclidienne donnerait naturellement davantage de poids aux variations numériques de l’âge. Pour éviter qu’une variable domine simplement parce que son unité produit de plus grands nombres, on peut standardiser chaque caractéristique. Cette transformation replace les variables sur des échelles comparables avant de calculer les distances.
Dans cette expression, μ représente la moyenne de la caractéristique et σ son écart-type. Le laboratoire interactif présenté sur cette page utilise cette standardisation pour comparer l’âge et la taille.
Voir la frontière de décision
Jusqu’à présent, nous avons demandé au modèle de classifier une seule nouvelle observation : Alex. On peut toutefois répéter exactement le même calcul pour un très grand nombre de positions réparties dans tout le graphique et observer quelle classe serait prédite à chaque endroit. En attribuant une couleur à chacune de ces prédictions, trois régions apparaissent progressivement. La séparation entre ces régions constitue ce que l’on appelle la frontière de décision du modèle.
Une caractéristique importante de la méthode des k plus proches voisins apparaît lorsque l’on fait varier la valeur de k. Pour k = 1, la prédiction dépend uniquement de l’observation la plus proche : les frontières de décision sont alors très sensibles aux observations individuelles et peuvent devenir locales et irrégulières. Lorsque k augmente, un plus grand nombre de voisins participe au vote, ce qui rend généralement la décision plus stable et les frontières plus régulières. Toutefois, une valeur de k trop élevée peut lisser excessivement la structure des données et masquer des différences locales importantes.
Dans une véritable analyse, la valeur de k n’est généralement pas choisie simplement parce qu’elle produit un graphique qui semble satisfaisant. On teste plutôt plusieurs valeurs de k à l’aide de données de validation ou d’une validation croisée, afin d’identifier celle qui permet au modèle de faire les meilleures prédictions sur de nouvelles observations, c’est-à-dire sur des données qui n’ont pas été utilisées pour construire le modèle.
KNN n’est pas limité à la classification
Notre exemple cherche à prédire une catégorie, ce qui correspond à une classification. Le même principe peut toutefois être utilisé lorsque la variable à prédire est numérique, par exemple le prix d’une maison ou une consommation énergétique. Au lieu d’effectuer un vote entre les classes des voisins, KNN peut alors calculer la moyenne de leurs valeurs.
Deux variables pour voir l’algorithme, mais beaucoup plus en pratique
L’exemple de cette page utilise volontairement seulement deux variables, l’âge et la taille. Ce choix n’est pas une limitation de KNN : il nous permet simplement de dessiner les observations dans un graphique bidimensionnel et de voir directement les voisins et les frontières. Une véritable observation peut contenir beaucoup plus d’informations. Nous pourrions, par exemple, ajouter une fréquence d’activité physique et représenter chaque personne avec trois caractéristiques plutôt que deux.
Avec trois caractéristiques, une représentation en trois dimensions est encore possible, même si elle devient déjà moins simple à interpréter. On peut ensuite ajouter une quatrième variable, une cinquième, ou des dizaines d’autres caractéristiques sans modifier le principe fondamental de l’algorithme.
À partir de quatre caractéristiques, nous ne pouvons plus représenter directement l’espace complet dans un graphique géométrique ordinaire. Cette limite concerne notre capacité à visualiser les données, et non la capacité de l’algorithme à travailler avec elles. Pour l’ordinateur, un point peut parfaitement posséder quatre, dix ou cent coordonnées.
La distance suit exactement le même principe
Avec deux caractéristiques, la distance euclidienne additionne les carrés des écarts selon deux directions avant de prendre la racine carrée. Lorsque de nouvelles caractéristiques sont ajoutées, il suffit d’ajouter les termes correspondants au même calcul.
Avec trois caractéristiques, un troisième terme apparaît. Le raisonnement reste identique, même si la géométrie correspondante se situe maintenant dans un espace tridimensionnel.
Pour un problème contenant p caractéristiques, cette logique se généralise naturellement. La distance peut alors être écrite sous une forme compacte à l’aide d’une sommation.
L’âge, la taille et les préférences sportives ont donc servi ici de support très simple pour rendre l’algorithme visible et manipulable. Dans des applications réelles, les données peuvent être beaucoup plus riches et comporter un grand nombre de caractéristiques, mais le principe fondamental demeure le même : rechercher les observations les plus proches dans l’espace des caractéristiques et utiliser leur information pour éclairer la prédiction. À mesure que le nombre de dimensions augmente, nous finissons par perdre la possibilité de voir géométriquement les voisins. KNN, lui, peut toujours calculer leur proximité, et c’est cette idée simple qui constitue le cœur de l’algorithme.
Laisser un commentaire
Une question, une remarque ou un complément à partager ?